مدیریت هشدار SCADA با نمایش تعداد آلارم تفاوت دارد
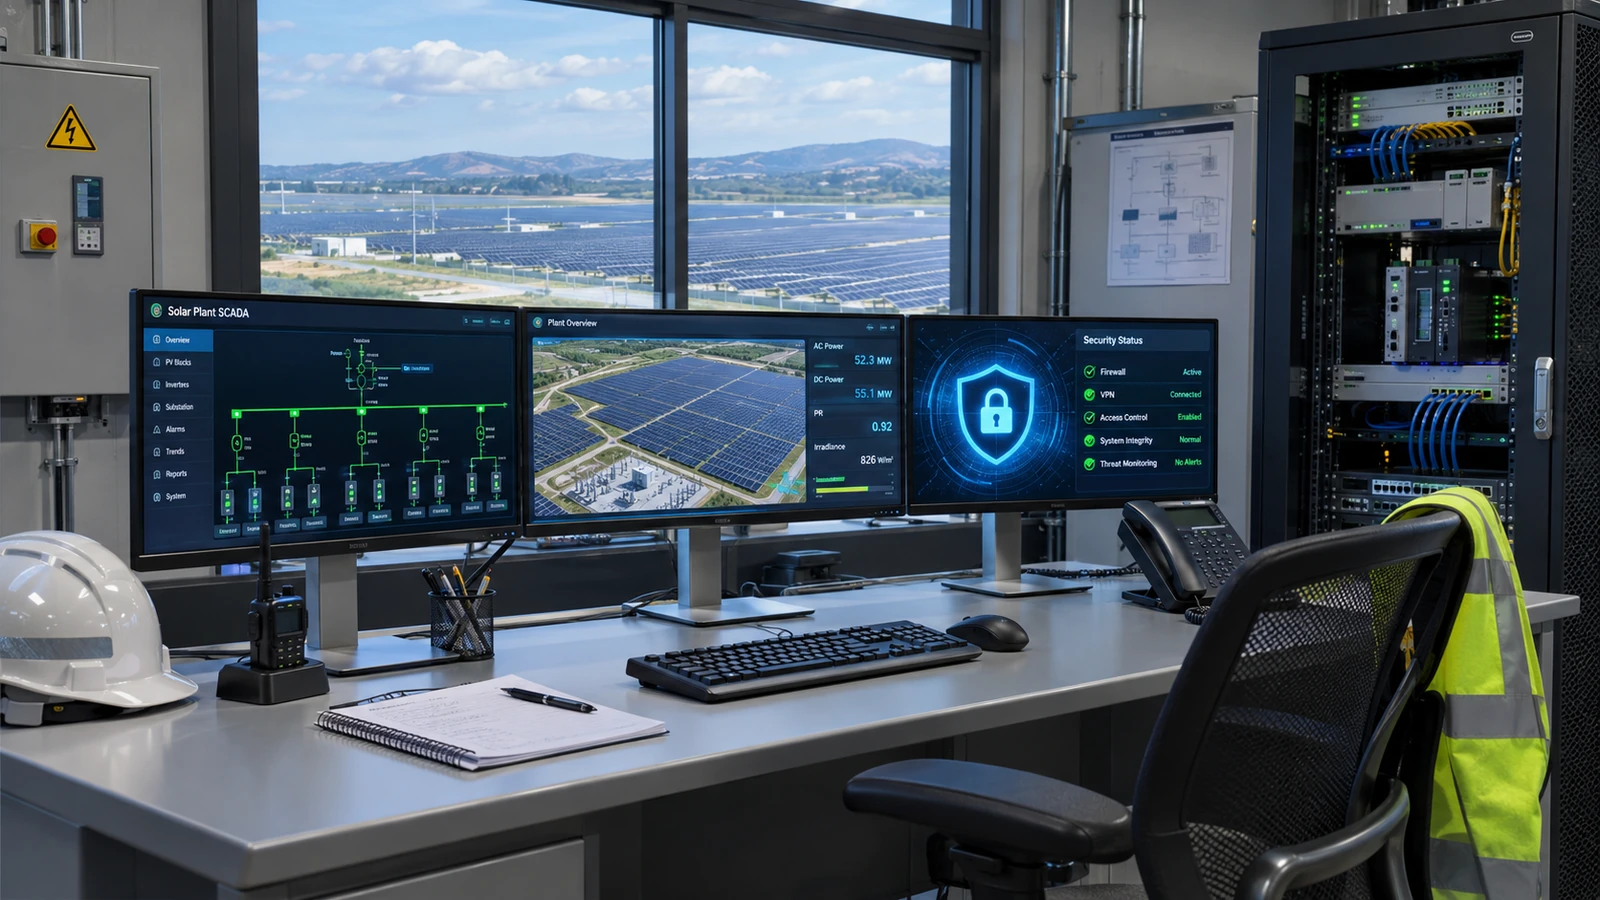
در نیروگاه خورشیدی، هزاران نقطه داده از اینورتر، ترانس، رله، کنتور، هواشناسی و ردیاب به SCADA وارد میشوند. اگر هر تغییر کوچک بهعنوان هشدار هماهمیت نمایش داده شود، اپراتور میان پیامهای پرشمار، رخداد بحرانی را دیر تشخیص میدهد. Alarm Management فرآیندی برای تعریف فلسفه هشدار، اولویت، شرط ایجاد، پاسخ اپراتور و ارزیابی عملکرد سامانه است.
استاندارد IEC 62682 اصول مدیریت هشدار صنایع فرایندی را تشریح میکند و میتواند برای طراحی رویههای متناسب با نیروگاه الهامبخش باشد. لازم است الزامات مالک نیروگاه و سازنده تجهیزات نیز لحاظ شود؛ نه اینکه استاندارد فرایندی را بدون انطباق بهعنوان گواهی خاص نیروگاه خورشیدی معرفی کنیم.
تمایز رویداد، هشدار و خطا
رویداد Event میتواند یک تغییر وضعیت عادی مانند آغاز تولید صبحگاهی باشد. هشدار Alarm باید شرایط غیرعادی معنادار را اعلام کند که واکنش مشخص اپراتور لازم دارد. خطای Fault ممکن است تشخیص داخلی تجهیز باشد؛ بسته به اهمیت آن همیشه نیازمند اعلان یکسان نیست.
برای مثال، قطع لحظهای ارتباط یک سنسور تکراری و قطع همه اینورترهای یک فیدر، دو پیام با پیامد متفاوتاند. فهرست هشدار باید شرح علت احتمالی، اقدام قابل انجام، زمان پاسخ و مسئول رسیدگی را کنار شناسه نقطه ذخیره کند.
اولویتبندی بر اساس پیامد و فوریت
اولویت هشدار باید با ماتریس پیامد و زمان در دسترس برای واکنش تعیین شود؛ صرف نام تجهیز یا عدد بزرگتر، معیار کافی نیست. خطر جانی یا آسیب جدی تجهیزات ممکن است اولویت بالایی بگیرد، درحالیکه هشدار افت تدریجی تولید در روز ابری اولویت پایینتری داشته باشد.
ماتریس باید تعداد محدود و واضحی سطح داشته باشد تا اپراتور بتواند در شرایط ازدحام تصمیم بگیرد. تعریف ۱۰ سطح مشابه که تفاوت اقدام آنها مشخص نیست، کیفیت عملکرد را بیشتر نمیکند.
حذف هشدارهای تکراری و Alarm Flood
Alarm Flood زمانی رخ میدهد که تعداد زیادی هشدار در بازه کوتاه ظاهر شود؛ برای مثال افت برق یک تابلو میتواند دهها پیام قطع ارتباط تجهیزات پاییندست ایجاد کند. اگر علت ریشهای قابل شناسایی باشد، منطق گروهبندی و Suppression مشروط میتواند پیامهای فرعی را مدیریت کند.
خاموش کردن دائمی هشدارها برای کاهش تعداد نمایش خطرناک است. هر سیاست Suppression باید مستند، قابل ردگیری و دارای شرط خروج باشد تا خرابی مستقل تجهیزات پشت علت مشترک پنهان نماند.
تنظیم Deadband و Delay
هشدار آنالوگ در نزدیکی آستانه میتواند مکرراً روشن و خاموش شود. Deadband و تأخیر زمانی به کاهش Chattering کمک میکنند، اما اگر بیش از حد بزرگ باشند تشخیص شرایط واقعی را عقب میاندازند. مقدار آنها باید با دینامیک فرایند و فوریت واکنش هماهنگ باشد.
در یک مثال فرضی، برای دمای تابلو که در اطراف ۶۰ درجه نوسان میکند، ممکن است آستانه ۶۰، بازگشت در ۵۷ و تأخیر معتبرسازی انتخاب شود؛ این اعداد تنها برای توضیح منطقاند و به هیچ تابلو یا باتری خاصی توصیه نمیشوند. آستانه واقعی از طراحی سازنده و تحلیل خطر تعیین میشود.
زمانبندی و همزمانی دادهها
اگر اینورتر زمان ثبت رویداد را با ساعت محلی و SCADA با UTC ذخیره کند، ترتیب رخدادها میتواند اشتباه تفسیر شود. سنکرونبودن ساعت تجهیزات با NTP یا روش مناسب و ثبت منطقه زمانی، بخشی از کیفیت تحلیل حوادث است.
برای گزارش علت ریشهای، دقت زمانی موردنیاز رله حفاظتی ممکن است بسیار بیشتر از سنسور دما باشد. باید کیفیت Time Stamp، زمان دریافت و زمان رویداد از یکدیگر جدا شوند؛ زمان رسیدن بسته به سرور لزوماً زمان وقوع خطا نیست.
مدیریت هشدار قطع ارتباط
قطع ارتباط نباید به شکل صفرشدن توان تفسیر شود. سامانه باید کیفیت داده را بهصورت مستقل ثبت کند و میان «صفر تولید»، «داده نامعتبر» و «عدم دریافت» تفاوت بگذارد. در غیر این صورت داشبورد ممکن است بدون رخداد واقعی افت تولید، هشدار غلط بدهد.
در شبکه بیسیم، قطع و وصل کوتاهمدت میتواند نیازمند تأخیر اعلام باشد؛ ولی این تأخیر نباید سبب پنهان شدن خاموشی واقعی یک فیدر شود. وضعیت تجهیزات همسایه و دروازه ارتباطی در تحلیل مفید است.
فرایند تصدیق و ارجاع
پس از ایجاد هشدار، اپراتور باید بتواند آن را تصدیق Acknowledge کند و اقدام انجامشده را ثبت کند. Acknowledge کردن به معنی رفع علت نیست؛ زمان بازگشت به حالت عادی و بستهشدن تیکت باید جداگانه نگهداری شود.
برای خطاهای مهم، مسیر Escalation به تیم برق، مانیتورینگ یا ایمنی باید زمانبندی و مخاطب مشخص داشته باشد. ثبت نام فرد، زمان واکنش، مستندات تعمیر و تکرار خطا به ارزیابی بهرهبرداری کمک میکند.
شاخصهای سلامت سامانه هشدار
نرخ هشدار به ازای هر اپراتور یا هر ساعت، تعداد هشدارهای مزمن، هشدارهای در وضعیت طولانی، متوسط زمان رسیدگی و تعداد هشدارهای تکراری شاخصهای مفیدی هستند. این شاخصها باید در بازههای همارز تحلیل شوند و با تغییر تعداد تجهیزات سایت مقایسه خام انجام نشود.
حذف صوری پیامها ممکن است عدد کل را بهبود دهد ولی کیفیت ایمنی را کاهش دهد. معیار موفقیت، دیدهشدن بهموقع شرایط مهم و اقدام درست است، نه کمترین تعداد ممکن هشدار.
تحویل دیتابیس آلارم
فهرست تحویل شامل شناسه یکتا، تجهیز، واحد، توضیح، آستانه، تأخیر، اولویت، شرط غیرفعالسازی، اقدام، مالک و مرجع تغییر است. تغییر تنظیمات در زمان بهرهبرداری باید نسخهدار باشد و امکان بازگشت داشته باشد.
آموزش اپراتور با سناریوهایی مانند خطای کنتور PCC، افت ارتباط جمعی و توقف یک ردیف ردیاب، بخش عملی تحویل است. هشدار بدون رویه پاسخ، فقط یک رنگ در صفحه SCADA خواهد بود.
دیدگاهها
0 دیدگاه تأییدشدهبه این مطلب امتیاز دهید
هنوز امتیازی ثبت نشده است.
هنوز دیدگاه ای ثبت نشده است.